PostgreSQL 18: fünf Änderungen, die sich auf Ihrer Datenbank testen lassen
PostgreSQL 18 bringt Async I/O, B-tree Skip Scan, uuidv7(), OAuth und neue Generated Columns. Wo das hilft, was es nicht verspricht und wie sich eine sichere Migration vorbereitet.
Der Release verändert mehrere Teile der Datenbank-Engine
PostgreSQL 18 erschien am 25. September 2025. Die Release Notes umfassen mehrere unabhängige Richtungen: asynchrones I/O für ausgewählte Read- und Vacuum-Operationen, B-tree Skip Scan, zeitlich geordnetes uuidv7(), virtuelle Generated Columns, OAuth-Unterstützung und zeitliche Constraints. [1] Das ist keine einzelne große Funktion mit Checkbox. Es ist ein Bündel von Möglichkeiten, die jeweils gegen Schema, Query-Pläne und Betriebsumgebung geprüft werden müssen.
Die schlechteste Bewertung wäre: ‚Postgres 18 ist dreimal schneller.‘ Das PostgreSQL Project berichtet über bis zu 3× Verbesserung in bestimmten Storage-Read-Szenarien; dieses Ergebnis gehört aber zu konkreten I/O-Bedingungen. [2] Eine Abfrage, die an CPU, Locks, Netzwerk, einem schlechten Index oder einem langsamen Upstream hängt, ändert sich nicht automatisch.
Ein besserer Upgrade-Grund ist ein konkreter Schmerz, den der Release berühren kann: große Scans und Vacuum-Arbeit, zufällige UUID-Primary-Keys auf einer Tabelle mit aktiven Inserts, Abfragen über eine nicht führende Spalte eines mehrspaltigen B-tree oder die Anbindung von Clients über einen Unternehmens-OAuth-Flow.
Was vor der Migration getestet werden sollte
Jede Fähigkeit unten hat einen klaren Test. Fehlt dieser Test, sollte sie nicht der Hauptgrund für ein Upgrade sein.
| Funktion | Wo sie helfen kann | Was zu testen ist |
|---|---|---|
| Async I/O | Sequential Scans, Bitmap Heap Scans, Vacuum und weitere unterstützte I/O-Operationen. | EXPLAIN (ANALYZE, BUFFERS) und Wall Time auf Staging mit produktionsähnlichen Daten vergleichen; Storage und die Einstellung io_method separat prüfen. |
| B-tree Skip Scan | Abfragen überspringen eine oder mehrere Präfixspalten eines mehrspaltigen B-tree, filtern aber spätere Spalten. | Pläne vor und nach dem Upgrade erfassen. Prüfen, ob ein bestehender Index jetzt verwendet wird, bevor auf Verdacht ein weiterer Index entsteht. |
uuidv7() | Neue Tabellen oder append-lastige Writes, die UUIDs und eine Erstellungszeitordnung benötigen. | Inserts, Indexgröße und Range Queries auf einer neuen Tabelle messen. Historische Primary Keys nicht ohne unabhängigen Business-Grund umschreiben. |
| Virtuelle Generated Columns | Abgeleitete Felder, die häufiger gelesen als geändert werden, oder bei denen eine gespeicherte Kopie unerwünscht wäre. | Read-Time-Berechnung mit dem bisherigen gespeicherten Ansatz vergleichen und Auswirkungen auf Abfragen und Indizes prüfen. |
| OAuth | Client-Verbindungen mit SSO oder Device-Authorization-Flow. | Treiber, Identity Provider, Scopes, Token Refresh und administrativen Notfallzugang testen. |
`uuidv7()` reduziert Zufälligkeit in neuen Schlüsseln, ersetzt aber kein Index-Design
UUIDv4 ist als verteilter Identifier nützlich, doch seine zufällige Reihenfolge verteilt neue Einträge über den gesamten B-tree. uuidv7() enthält eine Zeitkomponente, sodass neue Werte überwiegend in eine Richtung laufen. PostgreSQL 18 liefert die Funktion im Core. [1] Für neue externe Identifier ist das oft ein besserer Default als ein selbst erzeugtes UUIDv7 oder eine zusätzliche Extension.
‚Überwiegend‘ ist wichtig. UUIDv7 garantiert keine absolute Reihenfolge bei jedem parallelen Write, löst keine Contention auf einem heißen Index und ersetzt kein sinnvolles Partitioning. Es liefert einen Schlüssel, dessen Zeitordnung besser zur Insert-Reihenfolge passt. Der Gewinn gehört in den realen Write-Path-Metriken gesucht, nicht in der Form der ID.
Für ein bestehendes System ist ein Hybrid oft ruhiger: historische UUIDs bleiben, neue Tabellen oder Entitäten verwenden UUIDv7. Ein Austausch von Primary Keys im großen Maßstab berührt Foreign Keys, Caches, API-Verträge, Replikation und Backup-Prozesse. Ein Datenbank-Release allein ist kein Grund, dieses Risiko einzugehen.
Ein sicheres Upgrade beginnt mit Restore, nicht mit einem Production-Befehl
PostgreSQL nennt drei Hauptwege zwischen Major-Versionen: Dump/Restore, pg_upgrade oder logical replication. [1] Die Wahl hängt von akzeptabler Downtime, Datenmenge und Rollback-Anforderungen ab.
Baseline erfassen
Top Queries, EXPLAIN (ANALYZE, BUFFERS), Latenz, Autovacuum-Verhalten sowie Tabellen- und Indexgrößen sichern. Ohne Baseline lässt sich eine Regression nicht von normaler Workload-Variation trennen.
Produktionsnahes Staging wiederherstellen
Mehr als Schema-Migration testen: Extensions, Rollen, Jobs, Backup und Restore, Treiber und Integrationen. Nach pg_upgrade separat prüfen, ob Statistiken und Pläne wie erwartet arbeiten.
Kritischen Workload ausführen
Read- und Write-Pfade, Batch-Jobs, Maintenance-Windows und degradierte Fälle testen. I/O-Änderungen hängen vom eigenen Storage ab; ein synthetischer Benchmark ohne ähnliche Daten sagt wenig aus.
Rollback als technischen Plan formulieren
Stopp-Punkt, Integritätschecks, Entscheidungsverantwortung und Rückweg festlegen. Bei kurzer Downtime logical replication bewerten und den Cutover proben.
OAuth ergänzt Zugriffshygiene, ersetzt sie jedoch nicht
PostgreSQL 18 ergänzt OAuth-Support, und libpq implementiert einen optionalen Device-Authorization-Client-Flow. [3] Das ist nützlich, wenn Datenbankzugriff über Unternehmensidentität, Scopes und kurzlebige Tokens laufen soll. Nicht jeder Treiber und jeder Verbindungsweg unterstützt dies sofort; ein Kompatibilitätstest ist daher Pflicht.
Gleichzeitig setzt der Release die Bewegung weg von md5 Password Authentication fort; MD5-Unterstützung soll in einer zukünftigen Major-Version entfernt werden. [1] Das ist ein guter Zeitpunkt zu prüfen, ob alle Clients SCRAM unterstützen, wo Credentials liegen, wie Zugriffe rotiert werden und welche Service-Accounts noch übliche Regeln umgehen.
Das Upgrade sollte mit einer gemessenen Entscheidung enden
PostgreSQL 18 liefert genug Gründe, ein Upgrade auf die Roadmap zu setzen. Der stärkste ist je nach System anders: I/O und Maintenance hier, UUIDv7 für neue write-lastige Tabellen dort, mehrspaltige Indizes oder OAuth an anderer Stelle. Keiner dieser Gründe ersetzt Staging und Baseline.
Nach einem Pilot sollte das Ergebnis konkret sein: Upgrade, weil kritische Scans günstiger wurden; UUIDv7 nur für neue Tabellen; bestehende Indizes behalten; OAuth bis zur Treiberreife verschieben. Diese Entscheidungsliste ist nützlicher als die pauschale Aussage, eine neue Version sei ‚schneller‘.
Offizielle Quellen
Verwandte Artikel
Mau Saver zu einer Telegram-Gruppe hinzufügen und Medien im Chat speichern
Praktische Anleitung: Mau Saver zu einer Telegram-Gruppe hinzufügen und Videos, Audio und Posts direkt im Chat herunterladen.
Internationale Telegram-Media-Zielgruppen mit Werbung erreichen
Praktischer Leitfaden für Werbetreibende: Mau Saver, Telegram-Gruppen, angeheftete Beiträge und native Medienintegrationen.
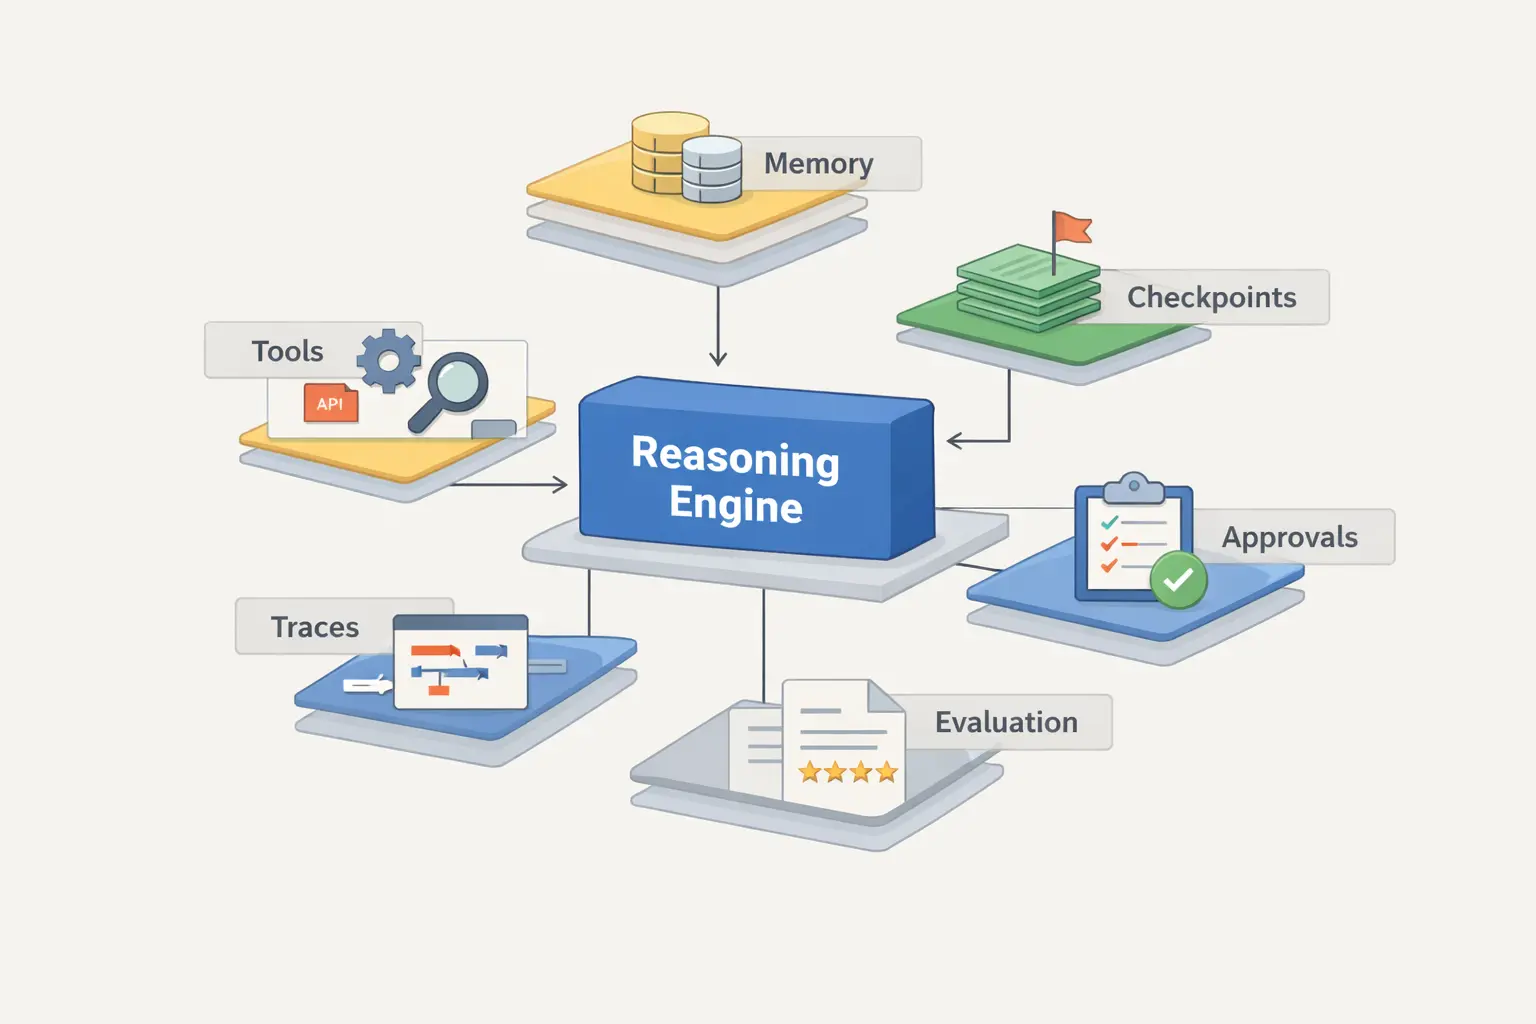
AI Assistant Entwicklung Kosten 2026: RAG, Knowledge Base, Integrationen und Support
Praktischer Leitfaden zu Kosten fuer AI Assistants: RAG, Knowledge Base, Channels, Tool Use, Guardrails, Evaluations, Monitoring und Support.
KI kann mehr erzeugen. Nicht besser: Was die Forschung über Spieleentwicklung sagt
Generative KI kommt in die Spieleproduktion, doch die Fakten sind nuancierter als der Hype. Wir betrachten Adoption, Spielervertrauen, Qualitätsrisiken und einen sinnvollen Workflow.